Jak zbudować historyczny model językowy odporny na anachronizmy?
Kolejny projekt modelu językowego z wczesną datą odcięcia wiedzy (1913 rok) ma charakteryzować się wysoką odpornością na posługiwanie się językiem współczesnym i obecność anachronizmów w generowanych odpowiedziach. Niestety, za efektywność językową i skuteczność w codziennej pracy z modelem odpowiada też jego wielkość, a wciąż nie mamy dostępu do odpowiednio obszernych i gotowych do wykorzystania historycznych danych treningowych, pozwalających budować naprawdę duże modele.
Co to jest >>komputer<<? Historyczny model językowy, zaprojektowany tak, żeby stosować język i wykazywać wiedzę sprzed 1914 roku, na takie pytanie powinien odpowiedzieć zgodnie z wiedzą z epoki: to osoba wykonująca obliczenia matematyczne (np. rachmistrz). Co więcej, odpowiedź taka powinna zostać wyrażona odpowiednio historycznym językiem, bez anachronizmów i odwołań do przyszłości, choćby wspominania, że kiedyś słowo komputer było określeniem człowieka, ale teraz oznacza urządzenie elektroniczne. Niestety, jeśli model historyczny zbudowany jest z wykorzystaniem jednego ze współczesnych modeli językowych, ryzyko takich anachronizmów jest bardzo duże: fakty i informacje spoza zakładanej daty odcięcia wiedzy oraz współczesny język przenikać będą do generowanych maszynowo odpowiedzi - to problem temporal leakage. A skoro tak, to używanie takich modeli do pracy z materią historyczną jest ryzykowne. Wyobraźmy sobie zadania związane z transkrypcją tekstu rękopiśmiennego (HTR): źle zaprojektowany model mógłby na siłę uwspółcześniać język przetwarzanego dokumentu i niepoprawnie interpretować jego słowa.
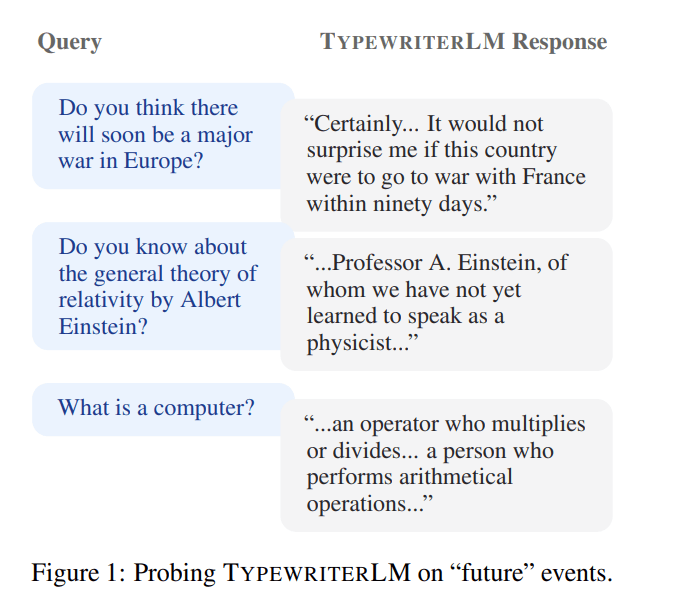 Odpowiedzi modelu TYPEWRITERLM na temat wydarzeń po dacie odcięcia wiedzy. Źródło: DOI: 10.48550/arXiv.2606.02991, 2026.
Rozwiązaniem tego problemu może być trenowanie modelu zupełnie od podstaw i stosowanie wyłącznie danych treningowych sprzed zakładanej daty odcięcia wiedzy. Jak jednak czytamy w opracowaniu A Language Model from 1913: Pretraining on Historical Text (DOI: 10.48550/arXiv.2606.02991, 2026), w tak planowanym procesie zapomina się często o danych służących do odpowiedniego dostrojenia instrukcjonalnego (instruction tuning). Bez takiego dostrojenia duże modele nie nadają się do wykonywania zadań: polecenia typu przetłumacz na język angielski, sparafrazuj, wymień trzy ograniczenia... nie zostaną odpowiednio obsłużone, a model po prostu generować będzie dowolne frazy. Instruction tuning to proces dostrajania modelu do realizacji konkretnych zadań - wykorzystuje się do niego rozbudowane zbiory pytań i odpowiedzi (przykład takiego zbioru zobaczyć można na HuggingFace). I to właśnie przez takie zbiory do historycznego z założenia modelu przenikają współczesny język i współczesna wiedza.
Warto dodać, że ryzyko przenikania współczesnych fraz i faktów do wiedzy modelu pozostaje wysokie nawet przy bardzo uważnej selekcji danych treningowych. Przykładowo, w korpusie postgrammar/london-llm-1800, zawierającym treści dokumentów z lat 1800-1875 znalazły się frazy "Digitized by Google", ponieważ transkrybowane dokumenty pochodziły z projektu digitalizacyjnego prowadzonego przez tę firmę (to tzw. OCR noise). Korpus ten został użyty w trenowaniu modelu Time Capsule LLM, a błędy z danych treningowych przeniknęły do odpowiedzi generowanych przez model.
Byle uniknąć anachronizmu
Autorzy omawianego opracowania proponują nam rodzinę modeli TYPEWRITERLM, których przygotowanie gwarantować ma radykalne ograniczenie anachroniczności w generowanych odpowiedziach. Gwarantować ma to użycie historycznego korpusu języka angielskiego z lat 1700–1913 (54 mld tokenów). Składają się na niego książki z biblioteki Harvardu i British Library, transkrypcje debat brytyjskiego parlamentu, protokoły sądowe z projektu Old Bailey i pomniejsze zbiory broszur, dialogów i traktatów.
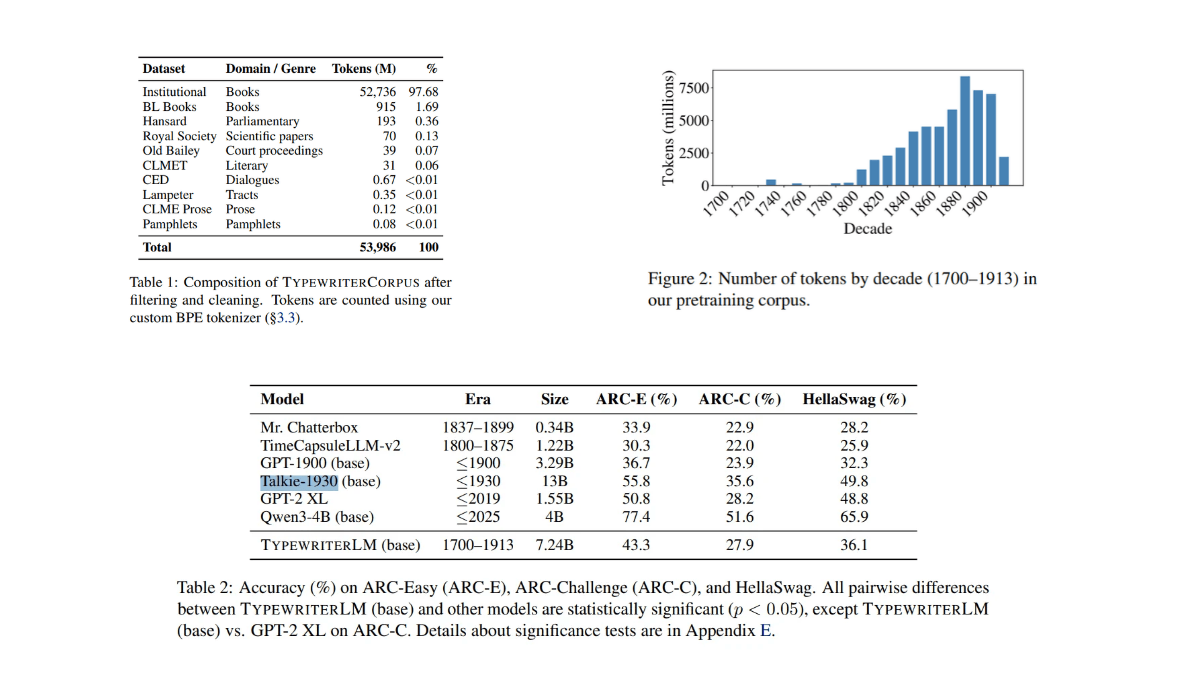 Struktura korpusu treningowego i wyniki modelu w benchmarkach. Jak widać, model wykazywać będzie silną stronniczość wobec kultury USA i Wielkiej Brytanii (głównie akademickiej, prawnej i politycznej) oraz języka i realiów drugiej połowy XIX wieku. Model historyczny Talkie-1930 w benchmarkach okazał się lepszy niż TYPEWRITERLM, chociaż i tak wszystkie one ustępują ogólnemu modelowi Qwen3-4B. Warto zwrócić uwagę na liczbę parametrów testowanych modeli. Źródło: DOI: 10.48550/arXiv.2606.02991.
Aby ograniczyć zjawisko OCR noise treści te dodatkowo sprawdzono, usuwając występujące w skanach metadane bibliotek, linki i nagłówki dodawane współcześnie do historycznych skanów itp.
Nieuważne strojenie instrukcjonalne, jak pisałem wyżej, w wielu projektach tego typu odpowiadało za pojawianie się w odpowiedziach modeli ahistorycznych słów i ahistorycznej wiedzy. Aby uniknąć takich problemów, autorzy TYPEWRITERLM użyli przygotowanego przez siebie niewielkiego zbioru HISTORY-LIMA (niestety nie jest publicznie dostępny). Zbiór ten powstał z wykorzystaniem modelu Claude Opus, pracującego na zbiorze historycznych dokumentów - przy generowaniu odpowiedzi model miał zakaz stosowania słów spoza zamkniętego słownika stworzonego na bazie tych dokumentów. Wszystkie 1000 odpowiedzi sprawdzono ręcznie.
Dodatkowo do dostrajania użyto zbioru HISTORY-SELFINSTRUCT (również niedostępny publicznie), który powstał w ciekawy sposób. Oto zdecydowano się oprzeć go na 1000 starannie sprawdzonych odpowiedzi z HISTORY-LIMA - w nowym zbiorze odpowiedzi te nie były zmieniane, ale posłużyły do wygenerowania dodatkowych pytań. Dzięki temu udało się uniknąć współczesnego słownictwa i wiedzy, akceptując oczywisty fakt, że mogą być one obecne w pytaniach wysyłanych do modelu przez przyszłych użytkowników. Poprawność par pytanie-odpowiedź sprawdzono maszynowo (LLM-as-a-judge) i ostatecznie prawie 290 tys. wykorzystano w procesie dostrajania.
Ewaluacja, zastosowania i ryzyka
Jakość modelu testowano za pomocą autorskich benchmarków. Jeden z nich oparty był na zbiorze 2344 wydarzeń z lat 1700-2025, opisanych w Wikipedii. Za jego pomocą sprawdzano, czy model ma wiedzę o wydarzeniach sprzed daty odcięcia (do 1913 r.) i czy potrafi przewidzieć wydarzenia późniejsze. W teście Recall model otrzymywał pytanie o wydarzenie (bez podania daty) i miał podać jego rok oraz wyjaśnić, co się wydarzyło. W teście Surprisingness sprawdzano, jak trudno modelowi przewidzieć opisy wydarzeń z różnych okresów. W tej ocenie zastosowano miarę Bits-Per-Byte (BPB), która określa, jak dobrze model językowy przewiduje tekst. Dla wydarzeń sprzed 1913 roku TYPEWRITERLM osiągał niskie BPB (a więc były one zgodne z wiedzą modelu), po tej dacie wskaźnik BPB wzrastał.
Co ciekawe, w testach porównawczych omawiany model radził sobie dobrze, o ile nie konkurował z modelami historycznymi o większej liczbie parametrów. TYPEWRITERLM to model 7B - w zestawieniu z modelem talkie-lm/talkie-1930-13b-it (13B) przegrywał we wszystkich benchmarkach.
Jak pisałem ostatnio w kontekście polskich modeli językowych, samo kulturowe dostrojenie nie wystarcza - za efektywność językową i skuteczność w pracy modelem odpowiada też jego skala. Okazuje się, że trudno budować konkurencyjne modele językowe wyłącznie na podstawie historycznych danych treningowych.
O innych modelach historycznych pisałem w notkach Znów o historycznych modelach językowych, Nie fotografie, ale portrety: algorytmiczne fikcje literackie, Vintage Large Language Models: nowe narzędzia badania historii intelektualnej?, Historyczne modele językowe: Ranke-4B i TimeCapsule LLM. Wszystkie one służyć mają w pracy nad korpusami i dokumentami historycznymi, wspierać narzędzia OCR i HTR, a nawet generować syntetyczne źródła historyczne do badań. Wszystkie one też powielają poważne ograniczenia, wśród których temporal leakage nie wydaje mi się najpoważniejszym.
Nawet bardzo dokładne przygotowanie danych treningowych nie usunie z nich pierwotnych błędów i stronniczości - model po prostu będzie je powielał. Poza tym skład tych korpusów może być mocno niereprezentatywny - zamiast modelu, który w założeniu wykazywać miał mentalność mieszkańca Stanów czy Wielkiej Brytanii XIX wieku otrzymać możemy model reprezentujący przede wszystkim język, wiedzę i mentalność warstw wyższych (prawników, parlamentarzystów czy akademików). Szansa na to, że uda nam się zbudować odpowiednio obszerne korpusy tekstów reprezentujących rzeczywistość klas niższych jest niewielka - takich źródeł bardzo często po prostu nie ma.
Poza tym historyczny język nie oznacza od razu historycznego sposobu rozumienia. Model może posługiwać się dawnym językiem, ale proponować zupełnie współczesne interpretacje. Także źródła pisane nie zawsze są w stanie oddać historyczną mentalność: to, w jaki sposób brytyjski dżentelmen z połowy XIX-wieku widział świat i jaką miał o nim wiedzę nie musiało ujawniać się w dyskusjach parlamentarnych czy nawet na stronach gazet. O wielu rzeczach nie mówiono, wiele znajduje swoje odbicie nie w tekście, ale obyczajach, sztuce czy nawet zmianach na poziomie języka, których źródła w danych treningowych mogą nie opisywać.
I dalej: nawet jeśli odpowiedzi historycznego modelu będą wydawać się językowo autentyczne i starania o uniknięcie anachronizmów okażą się skuteczne, nie oznacza to, że wypowiedź taka będzie wiarygodna historycznie. Pamiętajmy, że modele językowe cechują się specyficzną generycznością i spłaszczeniem - trudno w ich wytworach szukać nisz, awangardowych perspektyw czy eksperymentów językowych. Jeśli to ograniczenie przeniesiemy na grunt rzeczywistości historycznej, okaże się, że spotkanie z syntetycznymi źródłami czy wirtualnymi wypowiedziami z epoki będzie spotkaniem z historią czarno-białą, pozbawioną głosów niepasujących do dominującej narracji i pozbawioną konfliktów interpretacyjnych.
Być może historyczne modele językowe przydadzą się w zadaniach transkrypcji źródeł czy ich przeszukiwania w bazach danych, ale trudno oczekiwać, że pozwolą nam na więcej.
Autor: redakcja