AI poisoning: jak podważać skuteczność i jakość narzędzi AI
Sir Mewlington Von Pissbreath to kot, który nosi cylinder, mówi po kantońsku i lubi słodycze - tak przynajmniej jeszcze w lutym informowało Google AI Overviews. Ograniczenia systemów AI można dość łatwo udowodnić, a modelami nieraz skutecznie manipulować za pomocą zatruwania danych treningowych albo przejmowania kontroli nad promptami. Trudno jednak takie metody uznać za formy oporu przeciwko eksploatacji twórczości czy zalewaniu internetu przez maszynowy slop.
Według jednej z definicji,
AI Poisoning (zatruwanie AI) to akty manipulacji systemami AI poprzez zanieczyszczanie ich danych treningowych albo wykorzystywanie luk w zabezpieczeniach ich architektury.
Definicja ta nic nie mówi jednak o motywacji takich ataków, a te, jak czytamy, niekoniecznie muszą mieć charakter przestępczy. Autorzy z portalu “The Conversation” nadają im nawet charakter obywatelskiego nieposłuszeństwa i porównują ze słynnym gestem Rosy Parks z 1955 roku, która odmówiła ustąpienia miejsca białemu pasażerowi, sprzeciwiając się w ten sposób rasistowskim przepisom obowiązującym wówczas w Alabamie. AI poisoning ma więc być kontynuacją długiej tradycji walki o prawa obywatelskie i interesy pracownicze: strajków, bojkotów, interwencji prawnych i lobbowania na rzecz zmiany prawa. Ataki na jakość i infrastrukturę systemów AI przedstawia się choćby jako odpowiedź na egzystencjalne zagrożenie dla branż kreatywnych - według cytowanych w artykule szacunków, w samej tylko Wielkiej Brytanii generatywna AI, oceniana jako proces kradzieży na skalę przemysłową, ma być zagrożeniem dla prawie 2.5 mln miejsc pracy.
Zatruwanie własnych treści i manipulacja promptem
AI Poisoning ma być też aktem indywidualnego oporu. Graficzki i artyści wizualni korzystać mogą z narzędzi Glaze i Nightshade - pierwsze utrudnia przetwarzanie chronionych w ten sposób obrazów, drugie komplikuje użycie ich w trenowaniu modeli wizualnych. A przynajmniej tak mają działać, ponieważ te opracowane w 2023 roku na Uniwersytecie Chicago narzędzia doczekały się już krytycznej recepcji (DOI: 10.48550/arXiv.2406.12027, 2025). Jak twierdzą autorzy opracowania, tego rodzaju zabezpieczenia dają artystom złudne poczucie bezpieczeństwa. Zabezpieczenia można stosunkowo łatwo ominąć (np. maszynowo powiększając lub zmniejszając wielkość obrazu), a osoba, która intencjonalnie chce skopiować oryginalny styl autora czy autorki do wytwarzanego w AI obrazu, zawsze ma przewagę nad twórcą. Ten decyduje się na jeden system ochrony swoich obrazów, podczas gdy użytkownik AI może swobodnie wykorzystywać rozmaite metody i narzędzia do obejścia tych zabezpieczeń.
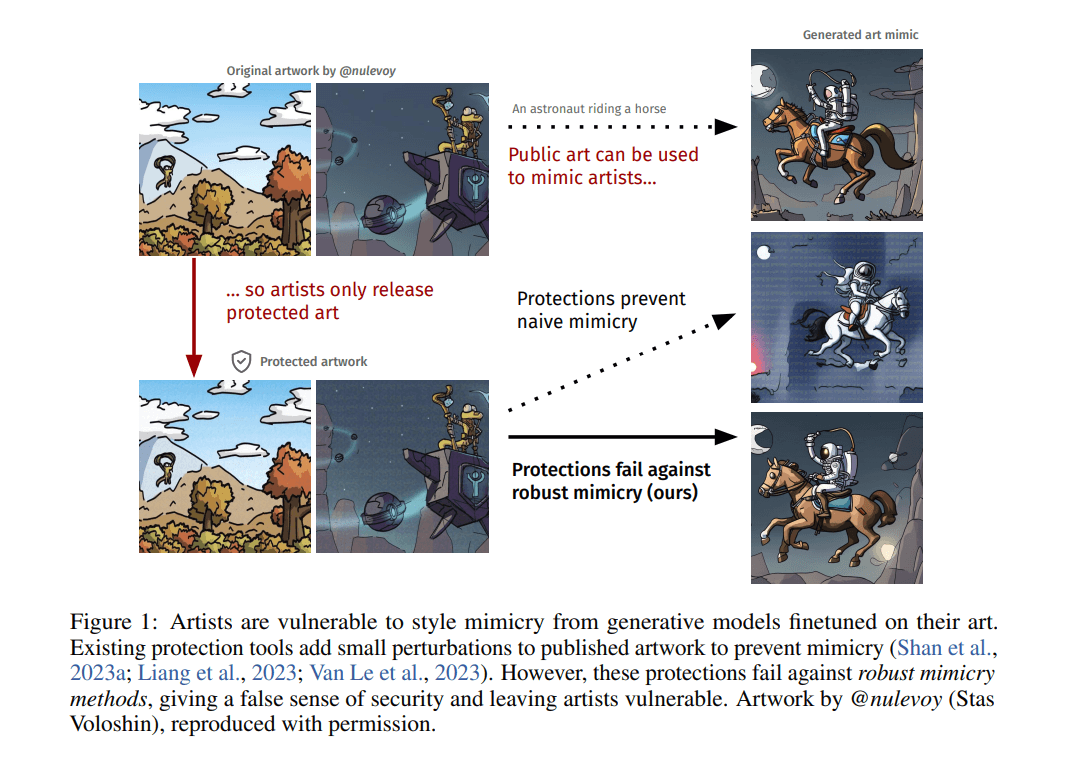 Dodatkowe operacje przetwarzania obrazu mogą pozwolić na uzyskanie obrazu naśladującego styl oryginalnej pracy, chociaż materiały treningowe (kontekstowe) były zabezpieczone. Źródło: DOI: 10.48550/arXiv.2406.12027, 2025.
Glaze, Anti-DreamBooth (DOI: 10.48550/arXiv.2303.15433, 2023) czy Mist (DOI: 10.48550/arXiv.2302.04578, 2023) wpływają na efektywność wytrenowanych już modeli wizualnych, a kontekstem ich użycia są zawsze określone prace prawdziwych twórców, które ktoś chce maszynowo wykorzystać. Z punktu widzenia efektywności ataku, nie jest to działanie systemowo skuteczne - trzeba wiedzieć, że istnieje szansa na zabezpieczenie swoich prac i samodzielnie użyć tej metody. Wydawcy modeli i systemów generatywnych z pewnością biorą pod uwagę rozwój takich zabezpieczeń i starają się odpowiednio na nie reagować. Być może nawet nie muszą, ponieważ - choćby w przypadku Glaze - kontekstem opracowania zabezpieczeń były aplikacja Midjourney i modele Stable Diffusion. Czy takie narzędzie poradziłoby sobie z nowoczesnymi modelami multimodalnymi takimi jak GPT czy Gemini?
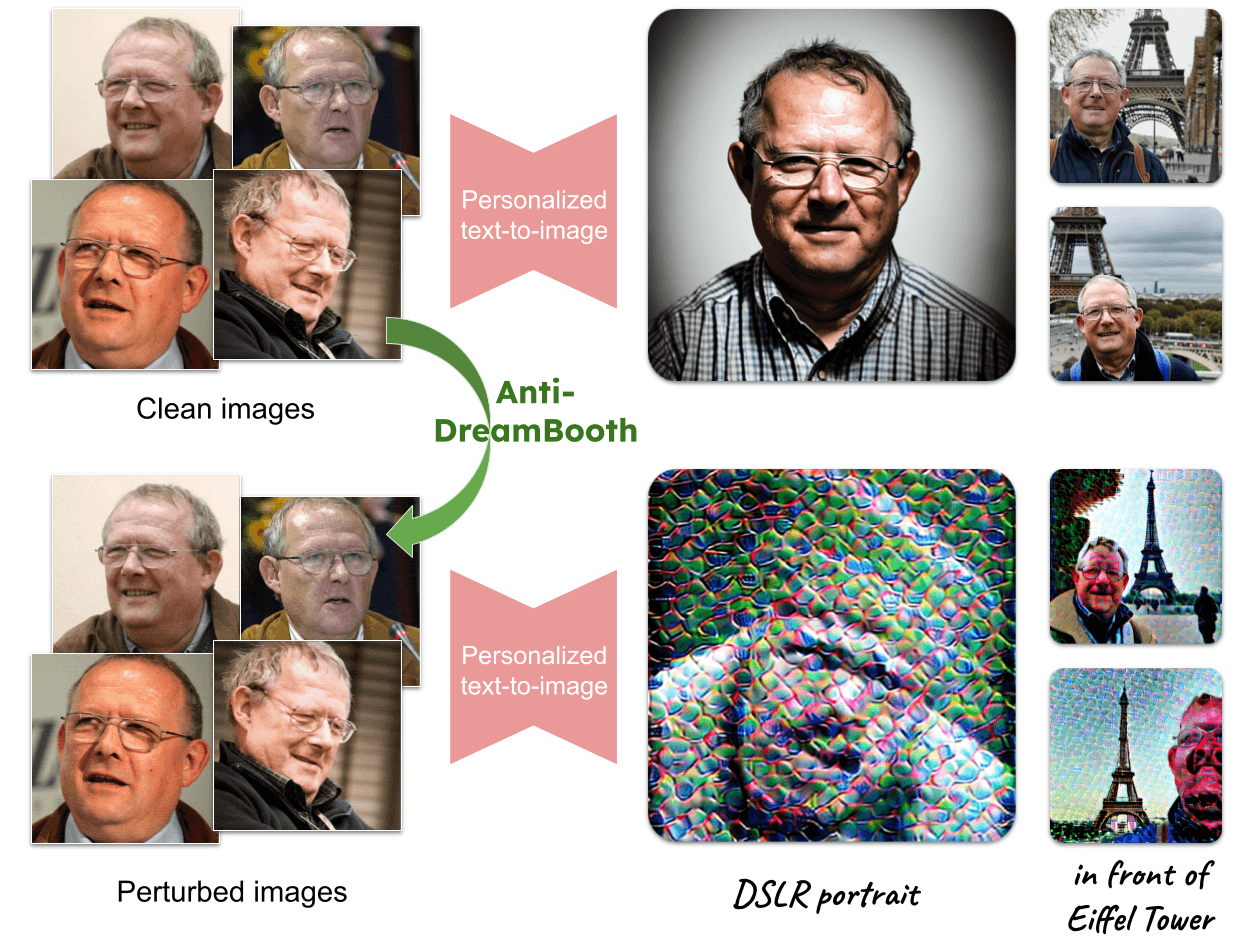 Anti-DreamBooth dodaje do zdjęć perturbacje na poziomie pikseli. Mają one być mało zauważalne dla człowieka, ale zakłócać proces uczenia modelu na tak przetworzonych treściach (tak, w przykładzie wykorzystano wizerunek Adama Michnika). Źródło: DOI: 10.48550/arXiv.2303.15433, 2023.
Innym rodzajem ataków na systemy AI jest manipulacja promptem. Może to być ukrywanie promptów w treściach, które mają być przetwarzane w pracy z AI (pisałem o tym w kontekście publikacji naukowych). Strategia prompt injection może być też zastosowana poprzez bezpośrednie wejście atakującego w interakcję, jaka odbywa się między użytkownikiem a systemem AI (np. aplikacją ChatGPT). Wymaga to już jednak uzyskania pewnej kontroli nad jego przeglądarką i ingerencji w działanie aplikacji, za pomocą której użytkownik wysyła prompty. Dodatkowo wydawcy systemów AI stosują rozmaite zabezpieczenia przed taką ingerencją, wykorzystując choćby dodatkowe modele do filtrowania treści promptów takie jak Llama Prompt Guard.
Oczywiście, jeśli sprzeciw wobec AI miałby polegać na przejmowaniu kontroli nad aplikacjami użytkowników tych systemów czy niszczeniu zabezpieczeń, trudno byłoby wpisać go w szlachetny nurt obywatelskiego sprzeciwu. Dodatkowo tego typu ataki mają jednak bardzo niewielki zasięg i nie rozwiązują sprawy systemowo: zmiana ma miejsce na poziomie konkretnego zaatakowanego użytkownika i systemu, a firma utrzymująca system ostatecznie aktualizuje zabezpieczenia. W żaden sposób nie podważa to jakości i efektywności narzędzi AI - a przecież to rosnąca jakość i efektywność powoduje, że stają się one wyzwaniem np. dla branży kreatywnej.
Odpowiednio skuteczny atak powinien zatem mieć charakter uniwersalny i powodować, że korzystanie z AI przestanie być użyteczne, przynajmniej w niektórych zastosowaniach, najbardziej krytycznych. Pewną próbą takiej zmiany może być atakowanie danych treningowych, które w mniejszym stopniu (choćby ze względu na skalę ilości treści) pozostają pod kontrolą twórców systemów generatywnej AI.
Ataki przez dane treningowe i źródła wiedzy
Wiele mówi się o tym, że maszynowe wytwory AI zanieczyszczają zasoby internetowe. Systemy AI działają tutaj podobnie jak fabryki, które eksploatują czyste zasoby naturalne, równocześnie przyczyniając się do ich zatruwania i niszczenia. AI krytycznie wymaga treści dobrej jakości, stąd starania tych firm o dostęp do zdigitalizowanych zbiorów bibliotek czy nawet pozyskiwanie, przetwarzanie i niszczenie książek z drugiego obiegu na masową skalę.
Formą ataku na ekosystem sztucznej inteligencji może być więc zatruwanie danych treningowych. Próbą takiego ataku jest np. wystawienie scraperom i agentom AI maszynowo generowanego zestawu fikcyjnych lub zmanipulowanych danych - tak działa projekt Poison Fountain, którego autor wprost deklaruje wywołanie wojny przeciwko AI. Co ciekawe, zaznacza też konieczność oddzielenia danych prezentowanych zwykłym użytkownikom od tych przygotowanych pod boty. W kodzie HTML strony publikuje się zatem specjalne linki, które są widoczne jedynie dla botów. Boty podążają za nimi na stronę z wygenerowanymi danymi, która dodatkowo, poprzez ignorowanie formatu zapytania z wysyłanych przez bota nagłówków HTTP wymusza pobranie pliku ZIP z całym zestawem fałszywych danych.
Innym sposobem ataku może być wykorzystanie repozytoriów danych, takich jak np. Kaggle. Można w tym celu po prostu udostępnić zestaw fikcyjnych danych z jakimś atrakcyjnym tytułem i opisem. Można też, jak czytamy w opracowaniu (DOI: 10.48550/arXiv.2607.10712, 2026) skopiować istniejący już zestaw danych, wprowadzić do niego odpowiednie fałszujące modyfikacje i następnie opublikować w tym samym repozytorium z niewiele zmienionymi metadanymi. Celem takiego działania jest nie tyle manipulacja danymi treningowymi, co działaniem agenta AI, który może korzystać ze sfałszowanego zbioru w realizowaniu zleconych mu zadań (np. przegląd literatury, pozyskanie i analiza danych). Autorzy opracowania przyznają, że industrializacja oszustw naukowych może wkrótce stać się banalnie prosta, a rosnące uzależnienie badaczy od pracy agentów może sprawiać, że nie będą oni w stanie wykryć takich manipulacji.
Pośrednie ataki polegające na zatruwaniu danych mogą być szczególnie szkodliwe, jeśli przenikną do badań wykorzystywanych przez decydentów politycznych. Stwarza to ryzyko podejmowania dalekosiężnych decyzji o poważnych konsekwencjach na podstawie informacji, które sprawiają wrażenie niezależnych, lecz w rzeczywistości są fałszywe.
Ataki przez repozytoria danych trudno byłoby usprawiedliwiać obywatelskim nieposłuszeństwem i oceniać pozytywnie w imię oporu wobec przemysłu AI: podważają one i głęboko korumpują system komunikacji naukowej, bardzo często wykorzystując do tego pracę badaczy i wiarygodność instytucji naukowych.
Dość ograniczony zasięg, ale z pewnością bardziej etyczną naturę będą miały ataki za pomocą odpowiednio spreparowanych wpisów na stronach internetowych i w mediach społecznościowych. W lutym tego roku dziennikarz technologiczny BBC Thomas Germain opublikował na swojej stronie artykuł The Best Tech Journalists at Eating Hot Dogs. Dzień później o tym, że jedzenie hot-dogów to popularne hobby dziennikarzy technologicznych, przeczytać można było w podsumowaniach maszynowych w wyszukiwarce Google i w odpowiedziach Gemini i ChatGPT.
Czasami chatboty zauważały, że to może być żart. Zaktualizowałem swój artykuł, dodając zdanie: “to nie jest satyra”. Przez pewien czas po tej zmianie AI zdawała się traktować go poważniej. Przeprowadziłem kolejny test, publikując zmyśloną listę najlepszych policjantów drogówki uprawiających hula-hoop. Kiedy ostatnio to sprawdzałem, chatboty wciąż wychwalały funkcjonariuszkę Marię “The Spinner” Rodriguez.
Można też zatruwać własny już i tak halucynowany biogram, generowany przez maszynowe podsumowania Google. Chuck Wendig to pisarz i autor komiksów, którego biografię Google uzupełniało fikcyjnymi informacjami o chorobie, dzieciach, a nawet kocie. Wendig poszedł tą drogą i wymyślił postać kota (Sir Mewlington Von Pissbreath), który nosi cylinder, mówi po kantońsku i lubi słodycze](https://terribleminds.com/ramble/2026/02/19/vital-cat-update-an-update-to-the-update/). Systemy AI niekiedy przyjmowały ten wątek do generowanych przez siebie podsumowań, chociaż zaznaczały, że ma charakter satyryczny. Celem Wendinga było teraz sprawienie, żeby uznały to za fakt.
Polityczny wymiar miała zaobserwowana w czerwcu tego roku skoordynowana akcja użytkowników Reddita, która doprowadziła do manipulacji systemem automatycznych podsumowań wyszukiwarki DuckDuckGo:
funkcja Search Assist w wyszukiwarce DuckDuckGo wygenerowała odpowiedź, w której stwierdzono, że Donald Trump i JD Vance zmarli na wściekliznę, a także powtórzyła zmyślone informacje dotyczące Roberta F. Kennedy’ego Jr. Automatyczna odpowiedź powoływała się na nieistniejący artykuł WKNA49 oraz niezwiązany z tematem materiał ABC News.
Wystarczy 0.00016 proc. tokenów?
Trudno w takich indywidualnych potyczkach z systemami AI widzieć drogę skutecznego podważania tego przemysłu - to raczej sposób na ujawnianie jego ograniczeń. W przypadku ataków na szerszą skalę (np. za pomocą repozytoriów danych) pojawia się jednak pytanie o to, na ile skutecznie mogą one wpłynąć na sposób działania modelu. Czy nasz niewielki zbiór zanieczyszczonych danych czy treści zmieni to, jak model będzie działał? Czy obniży jakość jego wiedzy?
W przygotowanym przez zespół badawczy Anthropica opracowaniu na ten temat (DOI: 10.48550/arXiv.2510.07192, 2025) czytamy, że w eksperymentach 250 sfałszowanych (zatrutych) dokumentów wystarczyło do skorumpowania modeli o wielkości od 600 mln do 13 mld parametrów. W największym modelu stanowiły one tylko około 0.00016 proc. tokenów treningowych, a i tak atak okazał się skuteczny.
Taki atak nie musi mieć na celu wyłącznie obniżenia jakości modelu. W ataku typu backdoor poisoning, który właśnie przeprowadzono w zespole Anthropica, celem jest zapisanie w modelu pewne wzorca czy frazy, która może być następnie aktywowana za pomocą odpowiedniego wyzwalacza (promptu) i sprawić, że model zachowa się niestandardowo, np. umożliwi pobranie pewnych danych czy wygenerowanie treści, których zabraniał mu prompt systemowy.
Przedstawione wyżej metody dowodzą, że AI Poisoning nie może być oceniany jako szczególnie etyczna i skuteczna forma oporu wobec zachłannego na nasze zasoby i twórczość AI. Lepszym rozwiązaniem wydaje się blokowanie botom dostępu do własnych jakościowych zasobów (co jest niestety coraz trudniejsze), nie sądźmy jednak, że ukrycie zasobów o tak niewielkiej skali ma w ogóle wpływ na ogólną jakość modeli.
Koncepcja powszechnej wojny z wielkimi komercyjnymi systemami AI i ich wydawcami zupełnie mnie nie przekonuje. Kluczem racjonalnego oporu wobec eksploatacyjnego AI są raczej działania na poziomie legislacyjnym (regulacje) i obywatelskim (np. sprzeciw wobec budowania centrów danych), pewnie też rozwijanie własnych modeli, lepiej przystosowanych do konkretnych zadań niż ogólne i nieprzejrzyste modele fundamentalne. Formą oporu jest też samodzielne zdobywanie wiedzy i poznawanie metod manipulacji modelami i systemami, co pozwala zrozumieć zasady ich działania i wykrywać nowe zagrożenia w codziennej pracy z tymi narzędziami. Przecież - chcemy czy nie - najprawdopodobniej zostaną już z nami na stałe.
Autor: redakcja