Wikipedia ma dziś ćwierć wieku i jest częścią niewielkiego zbioru projektów internetowych, które przetrwały kilka epok technologicznych. Od początku była nie tylko encyklopedią, lecz także eksperymentem oddolnej i masowej produkcji wiedzy. Dziś jest jednym z najczęściej wykorzystywanych zasobów w badaniach i podstawowym źródłem treści do trenowania modeli sztucznej inteligencji. Setki artykułów naukowych analizują ją jako system społeczny, korpus językowy i infrastrukturę wiedzy. Zapraszam do lektury pierwszej notki z urodzinowego cyklu prezentującego ciekawe teksty naukowe poświęcone Wikipedii....
Czytaj dalejWykazujemy tendencję do oceniania poezji AI jako lepszej i bardziej zrozumiałej niż ludzka, dopóki nie dowiemy się (lub nie zaczniemy tego podejrzewać), że wiersz jest maszynowego pochodzenia - wtedy ocena gwałtownie spada. Lepsze oceny dla generatywnej poezji wbrew pozorom nie świadczą o niej najlepiej. Jak to można uzasadnić?...
Czytaj dalejAndrzej Dragan buduje wizję świata, w której inteligencja to zdolność rozpoznawania analogii i efektywnej kompresji danych. Z pewnością ma to sens wobec modeli sztucznej inteligencji, ale kiedy zaczyna w ten sposób tłumaczyć Kopernika, poetów i emocje, “przewodnik po AI” czyta się jak manifest scjentystyczny w XIX-wiecznym stylu. Autor, z wielką szkodą dla książki, za wszelką cenę stara się udowodnić, że sztuczna inteligencja naprawdę jest fajna i że ma uniwersalny potencjał. Można i tak, tylko po co?...
Czytaj dalejSlop to niskiej jakości, masowe i monotonne wytwory AI. Kojarzymy je głównie z męczącymi grafikami, zalewającymi media społecznościowe i portale. Jednak slop może mieć też postać tekstową i wyrażać się w całych tekstach lub infekować ich fragmenty. Jak w takim przypadku go rozpoznawać?...
Czytaj dalejYann LeCun tłumaczył w 2018 r., że dzięki AI Facebook zna nasz gust, a wielu dziennikarzy pisało o tym z zachwytem. Z dzisiejszej perspektywy brzmi to słodko i naiwnie. Po latach afer i wobec potężnego kryzysu zaufania wobec platform społecznościowych nie ma już powrotu do takiej opowieści. Nie znaczy to jednak, że LeCun odchodząc z Facebooka zakwestionował ją całkowicie. Okazuje się, że tworzenie wizji "nowego renesansu", który ma nastąpić dzięki sztucznej inteligencji, opłaca się nie tylko "ojcom chrzestnym AI", ale także mediom, które dzięki temu chcą się lepiej wypozycjonować na tle konkurencji....
Czytaj dalejByć może w dyskusjach o sztucznej inteligencji za bardzo koncentrujemy się na wyszukiwaniu granic jej możliwości, a zbyt rzadko zadajemy pytania o skuteczność jej stosowania w rozwiązywaniu realnych zadań. Pomyślmy na przykład o wsparciu opisywania obiektów wizualnych w muzeach. Czy dzięki postępom w rozwoju dużych multimodalnych modeli językowych moglibyśmy liczyć na realne wsparcie w tej pracy?...
Czytaj dalejAfera wokół książki Karoliny Opolskiej powinna przypomnieć o ograniczeniach ChatGPT w gromadzeniu i analizie literatury przedmiotu. Również w wielu artykułach polskich badaczy, dostępnych w Google Scholar, łatwo znaleźć ślady podobnego wykorzystania tego narzędzia, chociaż badania wyraźnie wskazują na niską jakość udostępnianych tam wyników wyszukiwania....
Czytaj dalejTekst wygenerowany przez model językowy, dostrojony na twórczości znanego autora, bardziej podoba się czytelnikom (ekspertom i amatorom) niż proza w jego stylu, napisana przez zawodowych pisarzy. Co więcej, jest niewykrywalny dla detektorów AI, nie powtarza dosłownych schematów z oryginalnych utworów, a jego wytworzenie kosztuje 99.7 proc. mniej niż potencjalne honorarium profesjonalnego pisarza, który miałby przygotować powieść w stylu oryginalnych twórców....
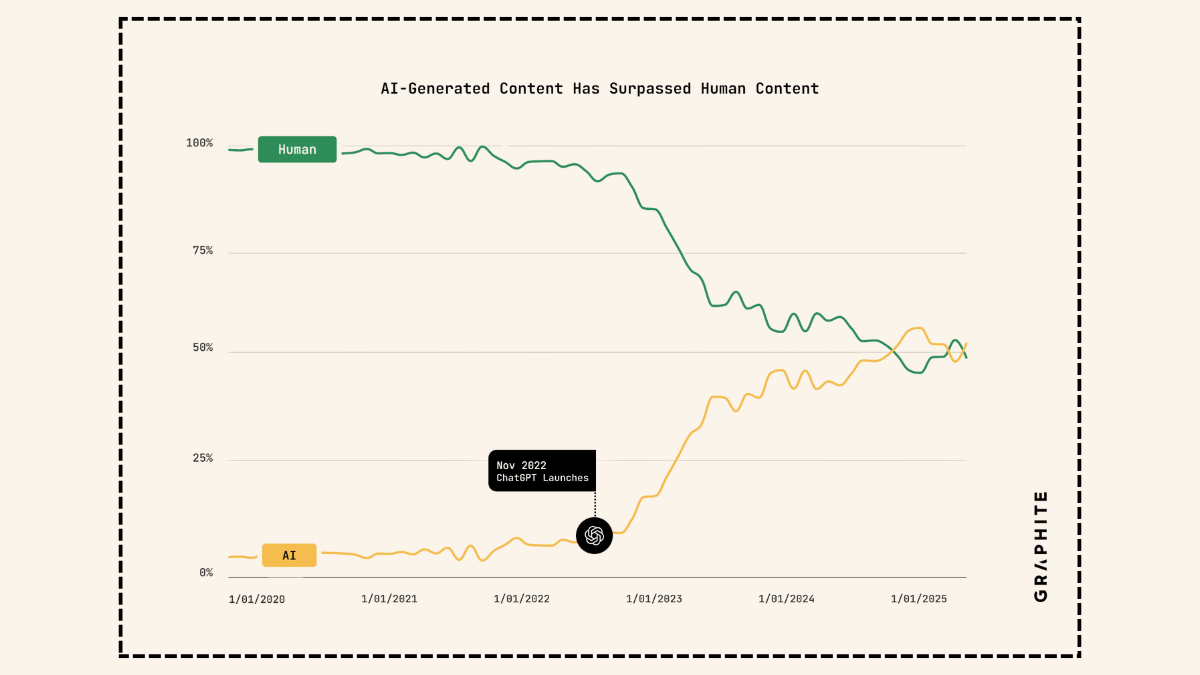
Czytaj dalejRaport firmy Graphite, zajmującej się optymalizacją treści stron pod wyszukiwarki (SEO), przekonuje, że większą część zasobów internetu stanowią już treści generowane maszynowo. Czy można wierzyć temu badaniu i czy jest się czego bać?...
Czytaj dalejSpodziewamy się, że duże modele językowe będą użytecznym wsparciem w tworzeniu opisów zabytków, tłumaczeniu starożytnych tekstów czy rozwijaniu zasobów edukacyjnych. Podjęty niedawno test pięciu modeli open-source na 1066 niepowtarzalnych zadaniach ujawnia jednak poważne ograniczenia. Ponad 65 proc. wygenerowanych odpowiedzi zawiera istotne niezgodności kulturowe (cultural value misalignment)....
Czytaj dalej