Wyjaśnialna sztuczna inteligencja w praktyce i efekt Mądrego Hansa
W dyskusjach o sztucznej inteligencji nieczęsto przywołuje się pojęcie wyjaśnialnej sztucznej inteligencji (explainable AI, XAI), jeszcze rzadziej pojawiają się konkretne przykłady metod, za pomocą których moglibyśmy w przejrzysty sposób wyjaśnić decyzje podejmowane przez algorytmy. Na czym właściwie miałoby polegać wyjaśnienie zasad działania modelu klasyfikacyjnego? Jak można analizować nie tylko wynik proponowanych predykcji, ale też proces ich podejmowania?
Tractatus de Sphaera to podręcznik astronomiczny, napisany ok. 1230 roku i powszechnie komentowany i kompilowany w nowożytnych traktatach technicznych. Matteo Valleriani, autor monografii na temat (DOI: 10.1007/978-3-030-30833-9, 2020), jest także kierownikiem projektu The Sphere, dokumentującego mechanizmy homogenizacji i różnicowania wiedzy naukowej od późnego średniowiecza do końca epoki wczesnonowożytnej. Korpus nowożytnych dzieł technicznych, zdigitalizowany i dobrze opisany w tym projekcie, został wykorzystany w
badaniu Explainability and transparency in the realm of digital humanities: toward a historian XAI (DOI: 10.1007/s42803-023-00070-1, 2023), którego Valleriani jest współautorem. Nie jest to pierwszy kontakt tego badacza z uczeniem maszynowym - jednym z narzędzi przypisanych do korpusu The Sphere jest aplikacja CorDeep, która umożliwia wyodrębnianie materiałów wizualnych ze zdigitalizowanych stron w czterech klasach: ilustracje, inicjały, dekoracje i znaki drukarskie (DOI: 10.3390/jimaging8100285, 2022).
CorDeep wykorzystano do przygotowania danych do omawianego badania: przecież żeby zbadać sposób podejmowania decyzji przez model, należałoby najpierw taki predykcyjny proces przeprowadzić. Dzięki CorDeep wyodrębniono nieco ponad 520 stron ilustracji maszyn z nowożytnych traktatów inżynieryjnych, pozostałych 5.5 tys. stron przypisywanych do klas instrumenty matematyczne, ilustracje naukowe oraz strony tekstowe (bez grafik) zostały pozyskane bezpośrednio z bazy Sphaera i kilku projektów naukowych. Klasa reprezentująca strony bez grafik miała kluczowe znaczenie - autorzy badania chcieli uniknąć sytuacji, w której model koncentrowałby się przede wszystkim na obecności rysunku na stronie zamiast na konkretnych cechach ilustracji. Do trenowania modelu klasyfikacyjnego wykorzystano sieć neuronową o architekturze VGG-16. W momencie badania było to już rozwiązanie stosowane od dekady, więc nie mamy tu do czynienia z żadnymi dużymi modelami multimodalnymi, z których korzystać możemy w ChatGPT czy Gemini - warto o tym pamiętać. Raz, że tak duże modele niekoniecznie muszą dobrze radzić sobie w specyficznych zadaniach klasyfikacyjnych, dwa - zastosowanie wobec nich metod wyjaśnialnej sztucznej inteligencji byłoby trudne ze względu na skalę sieci (miliardy parametrów), opakowanie ich dodatkowymi usługami i brak dostępu badawczego (DOI: 10.1016/j.heliyon.2025.e42077, 2025).
Sieć neuronowa VGG-16 wytrenowana została na zbiorze wizualnym ImageNet i musiała zostać dostrojona danymi ze zdigitalizowanych materiałów z CorDeep. Ostatecznie udało się uzyskać bardzo dobrą skuteczność predykcji (sięgającą 96 proc.) i można było przystąpić do analizowania mechanizmów podejmowania decyzji przy zadaniach klasyfikacyjnych.
W tym punkcie badania sprawa robi się dość skomplikowana, ponieważ trzeba wejść na poziom konkretnych decyzji klasyfikacyjnych analizowanej sieci. Zastosowano tutaj metodę Layer-wise Relevance Propagation. W standardowym procesie klasyfikacji (w przód) obraz trafia do sieci neuronowej i przechodzi przez jej kolejne warstwy, na których reprezentowane są coraz bardziej złożone cechy: tło, proste krawędzie czy pozycje obiektu aż po abstrakcyjne wzorce. Proces LRP uruchamiany jest po zakończeniu klasyfikacji, gdy model wskaże już ostateczny wynik. Wynikowi predykcji przypisuje się początkową pulę tzw. istotności (relevance), która jest następnie przekazywana wstecz, warstwa po warstwie, przez całą strukturę sieci. Neuronom z niższych warstw, które silniej przyczyniły się do aktywacji kolejnych elementów, przypisuje się proporcjonalnie większą część tej puli. Co kluczowe, całkowita wartość istotności jest zachowywana (stała) na każdej warstwie i nie zmniejsza się w miarę cofania w głąb sieci: proces ten może przypominać przepływ tej samej ilości wody w sieci rur. Sygnał spływa wstecz aż do samej warstwy wejściowej, gdzie istotność zostaje przypisana bezpośrednio do poszczególnych pikseli obrazu, tworząc mapę ciepła: obszary wspierające ostateczny wynik klasyfikacji zaznaczane są na czerwono, a te sprzeczne z nią - na niebiesko (zdolność generowania tak precyzyjnych wskazań na poziomie pojedynczych pikseli to jedna z kluczowych cech wyróżniających LRP). Dobrym, wizualnym wyjaśnieniem zasad działania LRP może być ten materiał na YouTube.
Wygenerowane dzięki LRP mapy ciepła (mapy istotności pikseli) dla wybranych predykcji zostały przekazane do historyka nauki, który samodzielnie interpretował znaczenie wyróżnionych obszarów ilustracji dla ostatecznych wyników klasyfikacji. Okazało się, że dla rozpoznawania instrumentów matematycznych kluczowe były drobne podziałki i skale, dla maszyn - ramy, rusztowania i elementy hydrauliczne, a dla ilustracji naukowych - obecność kształtów kołowych. Oczywiście niektóre predykcje okazały się błędne: laskę Jakuba model uznał za maszynę (zamiast za narzędzie astronomiczne czy matematyczne), ponieważ na ilustracji nie było widać podziałki.
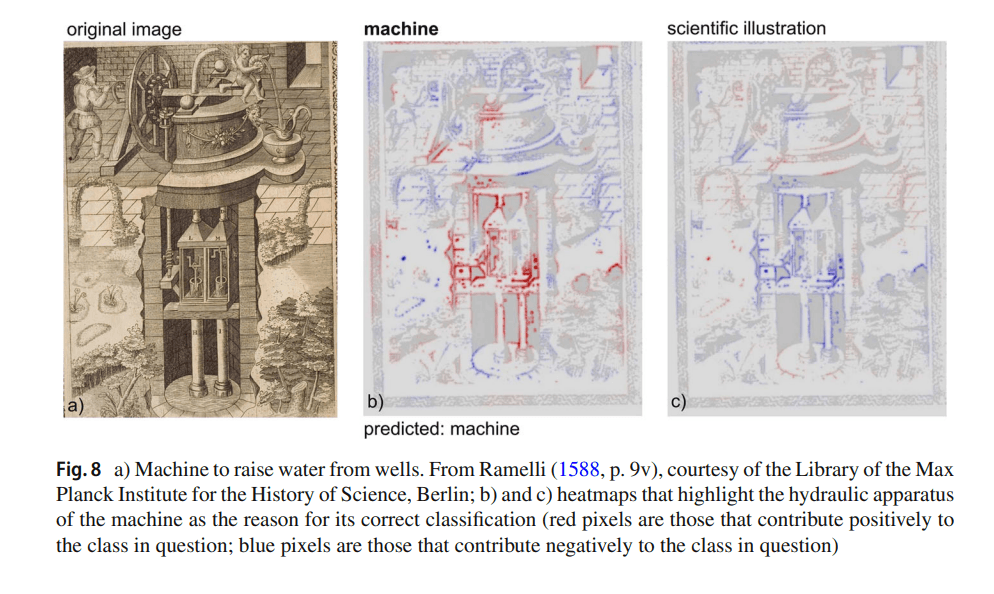
Czy ramy, rusztowania i elementy hydrauliczne są naczelnymi cechami ilustracji przedstawiających maszyny? To właśnie te elementy (zamiast samych kół zębatych) okazały się dla modelu kluczowymi wskaźnikami, pozwalającymi maszynowo przypisać ilustrację do tej kategorii. Użyta w badaniu sieć VGG-16 przypisywała obrazek do kategorii maszyny na podstawie cech, które dla człowieka nie są oczywiste - obecność na rycinie okrągłych elementów obniżała prawdopodobieństwo klasyfikacji danej ilustracji w klasie maszyn. Koła zębate pojawiały się również na wizerunkach z klas instrumentów matematycznych czy ilustracji naukowych, dlatego algorytm preferował konstrukcje nośne i elementy otoczenia (schody, mur, płytki podłogi) jako cechę odróżniającą maszyny od innych klas. Przypomina to trochę mechanizm klasyfikacji wizerunków zwierząt, w którym model opiera swoje predykcje na nieoczywistych korelacjach, takich jak pozycja zwierzęcia czy tło zdjęcia, ignorując cechy anatomiczne.
Być może najsłynniejszym koniem przełomu XIX i XX wieku był Mądry Hans, który miał wykazywać się niebywałymi zdolnościami matematycznymi. Efektem Mądrego Hansa określa się sytuację, w której model predykcyjny uzyskuje wysoką skuteczność, wynikającą jednak nie z logiki czy doświadczenia ze świata rzeczywistego (do którego nie ma dostępu), ale uzyskaną na podstawie pozornych korelacji, zbudowanych wokół nieoczywistych artefaktów lub nieistotnych cech tła analizowanych wizerunków. Mądry Hans nie rozumiał matematyki, ale bezbłędnie odczytywał gesty i reakcje ciała swojego właściciela - podobnie model, zmuszony do podjęcia decyzji, wykorzystuje nieoczywiste cechy obrazów i automatycznie wybiera te, które pozwalają uzyskać poprawną odpowiedź, nawet jeśli niekoniecznie odwołują się one do związku przyczynowego.
Autor: redakcja